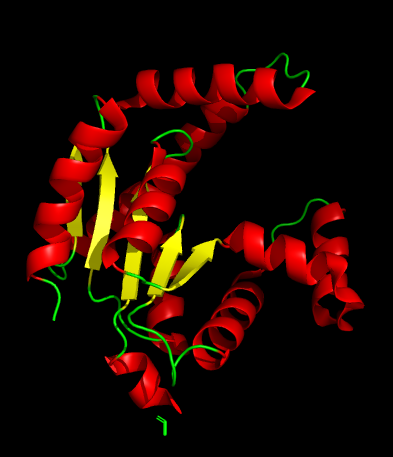
Las proteínas son cadenas formadas por aminoácidos que ejercen las principales funciones celulares, desde acelerar reacciones químicas a sintetizar todas las componentes de las células y regular el ciclo de las células y su diferenciación.
Muchas proteínas necesitan adoptar una estructura tridimensional concreta para funcionar correctamente, y esta estructura nativa, y la dinámica que se le asocia, son una diana de la selección natural, que deja rastros complejos en las secuencias de las proteínas. La huella más sencilla reside en la frecuencia con la cual observamos determinados aminoácidos en una posición determinada (aminoácidos que desarrollan funciones catalíticas, pero también aminoácidos hidrofóbicos en posiciones enterradas y polares en posiciones expuestas al agua), pero hay huellas más complejas que se revelan en combinaciones de aminoácidos que aparecen juntos con frecuencia diferente de la esperada en determinados pares de posiciones.
Estas correlaciones evolutivas son muy útiles para estudiar la estructura de las proteínas. De hecho, este tipo de información ha sido fundamental para desarrollar herramientas de predicción estructural como AlphaFold. Sin embargo, todavía hay debate sobre los procesos evolutivos que generan estas correlaciones.
Un nuevo trabajo propone un modelo matemático en el cual la selección natural actúa sobre la estabilidad de las proteínas, es decir, sobre su capacidad para adoptar y mantener su estructura correcta, y predice frecuencias de combinaciones de aminoácidos muy similares a las observadas en proteínas naturales.
No basta con evitar que la proteína se “despliegue”
El modelo desarrollado por los investigadores tiene en cuenta dos problemas diferentes. Por un lado, una proteína debe ser suficientemente estable para no desplegarse. Por otro, debe evitar adoptar estructuras alternativas incorrectas que también podrían resultar estables.
Este segundo proceso se conoce como diseño negativo frente al mal plegamiento. En la práctica, significa que algunas combinaciones de aminoácidos son favorecidas en determinadas posiciones precisamente porque dificultan que una proteína adopte una estructura incorrecta.
El estudio muestra que este mecanismo puede dejar una huella detectable en las secuencias de las proteínas. Así, cuando dos posiciones están próximas en la estructura tridimensional y forman un contacto, tienden a aparecer combinaciones de aminoácidos que contribuyen a estabilizar esa estructura, y cuya frecuencia está determinada por su energía libre de interacción según una distribución de Boltzmann. En cambio, en determinadas posiciones que están próximas en la cadena pero que no deberían entrar en contacto en la estructura final, se favorecen combinaciones que dificultan interacciones no deseadas.
Una explicación para las correlaciones que vemos en las proteínas
Para comprobar sus predicciones, los investigadores analizaron 37.108 cadenas de proteínas no redundantes del Protein Data Bank, la mayor base de datos de estructuras de proteínas. Compararon las correlaciones entre parejas de posiciones teniendo en cuenta si estaban en contacto, su distancia dentro de la cadena y si se encontraban en el interior o en la superficie de la proteína.
Los resultados muestran que el modelo reproduce buena parte de las correlaciones observadas. En general, las predicciones son especialmente consistentes para posiciones que forman contactos en la estructura tridimensional.
El análisis también revela que las correlaciones más intensas no siempre corresponden a posiciones del interior de la proteína. Las parejas de posiciones situadas en la superficie y que están en contacto presentan una información evolutiva particularmente elevada. Según los autores, esto apunta a que, además de la estabilidad, podrían intervenir otros factores relacionados con la función de las proteínas o con sus interacciones con otras moléculas.
La evolución deja muchas pistas en las secuencias
El trabajo también identifica correlaciones entre aminoácidos que no parecen depender directamente de la estructura de la proteína, ya que se detectan para todos los pares de posiciones. Estas pueden reflejar cambios generales en las presiones selectivas o en las tasas de mutación que afectan a diferentes organismos.
Por ejemplo, los aminoácidos iguales tienden a presentar fuertes correlaciones globales. El caso más destacado es la cisteína, relacionada con la formación de puentes disulfuro, enlaces que pueden contribuir a estabilizar determinadas proteínas. También aparecen agrupaciones de aminoácidos relacionadas con su coste metabólico, su carga eléctrica, la polaridad de su cadena lateral o con las características del código genético.
En conjunto, los resultados muestran que las correlaciones entre posiciones de una proteína pueden surgir de una combinación de factores: las necesidades de estabilidad de su estructura, la necesidad de evitar el mal plegamiento y otras presiones evolutivas que actúan sobre la proteína en su conjunto.
El estudio proporciona así un marco teórico para comprender mejor por qué las secuencias de proteínas contienen tanta información sobre su estructura y cómo la evolución utiliza diferentes estrategias para mantenerlas funcionales.
Referencia
Saebi F, Minning J, Bastolla U. Selection for Folding Stability Predicts Observed Covariation Between Protein Positions in the PDB. J Mol Evol. 2026 Sep 23. doi: 10.1007/s00239-026-10348-x. Epub ahead of print. PMID: 42776216.